NHUBB网站设计开发社区

专业架构评估与优化方案:TiHUBB_Schema 与 TSF 的深度融合

评估下 core/schema.php 与SEO插件TSF的融合,首先以templates/page-web-development.php 作为MVP来处理。1、TSF主要管Meta,涉及 application/ld+json的部分如果应用了 TiHUBB_Schema则要把TSF的内容接管,防止页面出现两个 application/ld+json;2、前端模板的application/ld+json数据,我们可能来源模板本身,也可能来自后台,两个场景需要考虑到

专业架构评估与优化方案:TiHUBB_Schema 与 TSF 的深度融合(以 page-web-development.php 为 MVP)

作为 WordPress 主题/插件资深架构师,我对当前 core/schema.php 的设计思路给予肯定:通过队列 + 单一输出 + 拦截 TSF 的方式,是符合企业级可维护性的正确方向。下面给出结构化诊断 + 具体优化方案。


一、当前问题诊断(MVP 视角)

  1. 重复输出风险(Critical)
    • page-web-development.php 中同时存在:
      • TiHUBB_Schema::add($web_development_schema)
      • 直接 echo ‘<script type=”application/ld+json”>’
    • schema.php 在 wp_footer 又会再输出一次完整的 @graph。
    • 结果:页面会出现 2 个 application/ld+json 脚本,违反 Google 最佳实践,可能触发结构化数据解析警告。
  2. TSF 拦截的健壮性
    • 当前 intercept_and_silence_tsf() 使用 the_seo_framework_ld_json_scripts 过滤器是正确的(TSF 核心钩子)。
    • 但优先级 9999 仍可能被其他插件/主题覆盖,且未完全处理 TSF 在 wp_head 直接输出的情况。
  3. 数据来源双场景未统一
    • 模板硬编码(当前 page-web-development.php)
    • 后台动态(ACF)(tihubb_register_schema action 中已预留)
    • 需要建立统一注册入口,避免模板和核心逻辑耦合过紧。

二、推荐最终架构(MVP 立即可落地)

1. 修改 core/schema.php(核心强化)

PHP

<?php
/**
 * TiHUBB Schema 引擎 v2.0 - 企业级单脚本输出 + TSF 完全接管
 */

if (!defined('ABSPATH')) exit;

class TiHUBB_Schema
{
    private static $schema_queue = [];

    public static function init()
    {
        // 更高优先级拦截 TSF
        add_action('plugins_loaded', [__CLASS__, 'intercept_tsf'], 5);

        // 统一输出(推荐 wp_head 靠前位置,更利于 SEO 爬虫)
        add_action('wp_head', [__CLASS__, 'render'], 99);

        // 注册页面级 Schema(推荐方式)
        add_action('wp', [__CLASS__, 'register_page_schemas']);
    }

    /**
     * 强化 TSF 拦截
     */
    public static function intercept_tsf()
    {
        // 彻底禁用 TSF 原生 JSON-LD 输出
        add_filter('the_seo_framework_ld_json_scripts', '__return_empty_array', 9999);

        // 吸收 TSF 已生成的内容(兼容旧数据)
        add_filter('the_seo_framework_ld_json_scripts', function($scripts) {
            if (empty($scripts)) return $scripts;

            foreach ((array)$scripts as $item) {
                if (is_array($item)) {
                    self::add($item);
                }
            }
            return [];
        }, 9998);
    }

    /**
     * 统一注册入口
     */
    public static function register_page_schemas()
    {
        if (!is_page_template('templates/page-web-development.php')) {
            return;
        }

        // 触发自定义 action,允许 ACF 或其他逻辑注册
        do_action('tihubb_register_schema');
    }

    public static function add($data)
    {
        if (empty($data) || !is_array($data)) return;

        // 清理多余 context
        if (isset($data['@context'])) {
            unset($data['@context']);
        }

        // 防重复 @id
        $id = $data['@id'] ?? null;
        if ($id) {
            foreach (self::$schema_queue as $existing) {
                if (($existing['@id'] ?? null) === $id) {
                    return;
                }
            }
        }

        self::$schema_queue[] = $data;
    }

    /**
     * 单一输出 - 推荐放在 wp_head
     */
    public static function render()
    {
        if (is_admin() || empty(self::$schema_queue)) return;

        $final_schema = [
            '@context' => 'https://schema.org',
            '@graph'   => self::$schema_queue
        ];

        echo "\n<!-- TiHUBB Schema Engine -->\n";
        echo '<script type="application/ld+json" class="tihubb-schema-graph">';
        echo wp_json_encode($final_schema, JSON_UNESCAPED_UNICODE | JSON_UNESCAPED_SLASHES);
        echo "</script>\n";
    }
}

TiHUBB_Schema::init();

2. 优化 templates/page-web-development.php

关键修改:移除直接输出,只负责数据注册

PHP

<?php
// ... 头部保持不变

$web_development_faqs = [ /* ... */ ];

// 构建 Schema(推荐结构)
$web_development_schema = [
    '@type'       => 'Service',
    '@id'         => trailingslashit(get_permalink()) . '#web-development-service',
    'name'        => '网站建设与 WordPress 定制开发服务',
    // ... 其他字段
];

$faq_schema = [
    '@type'      => 'FAQPage',
    '@id'        => trailingslashit(get_permalink()) . '#web-development-faq',
    'mainEntity' => array_map(/* ... */ , $web_development_faqs),
];

// 统一注册(不再直接 echo)
TiHUBB_Schema::add($web_development_schema);
TiHUBB_Schema::add($faq_schema);

// 删除原来的 <script type="application/ld+json"> 块!!!

get_header();

3. 动态 ACF 场景支持(推荐)

在 tihubb_register_schema action 中完善:

PHP

add_action('tihubb_register_schema', function() {
    if (!is_page_template('templates/page-web-development.php')) return;

    // ACF 动态 FAQ 示例
    $faqs = get_field('faq_items'); // Repeater 字段
    if ($faqs) {
        $mainEntity = [];
        foreach ($faqs as $faq) {
            $mainEntity[] = [
                '@type'          => 'Question',
                'name'           => $faq['question'],
                'acceptedAnswer' => ['@type' => 'Answer', 'text' => $faq['answer']],
            ];
        }

        TiHUBB_Schema::add([
            '@type'      => 'FAQPage',
            '@id'        => trailingslashit(get_permalink()) . '#faq',
            'mainEntity' => $mainEntity,
        ]);
    }

    // Service Schema 可从 ACF 读取标题、描述等
});

三、架构总结与后续演进建议

当前 MVP 优化优先级:

  1. 立即执行:移除模板中的直接 <script> 输出 + 升级 schema.php。
  2. 测试验证:使用 Google Rich Results Test + Schema Markup Validator。
  3. 监控:确保 TSF 的 Organization / WebSite 等全局 Schema 被成功吸收。

长期演进方向:

  • 将 Schema 注册做成 TiHUBB_Schema_Registry 单例,支持按模板/CPT 自动加载。
  • 支持 BreadcrumbList、WebPage、Organization 等全局节点自动合并。
  • 增加缓存层(Transient),避免高并发下重复构建。
  • 考虑与 Rank Math / Yoast 的兼容拦截策略(类似 TSF 处理)。

本地WPAPI推送到Vercel的Web应用部署方案

这是一个非常经典且高效的 Headless WordPress (去中心化 / 无头 WordPress) 架构。

在这种架构中,WordPress 不再负责前台的渲染(不用 WP 的主题),而是退居幕后作为一个纯粹的 CMS(内容管理系统)兼后台管理面板。而 Vercel 上部署的 Web 应用(通常是 Next.js、Nuxt.js 或 Astro 等现代前端框架)则通过 API 获取数据,并负责极致的视觉呈现和用户体验。

对于追求极致视觉(如 Swiss Style、现代杂志感编辑排版)和高性能的品牌站点来说,这是非常理想的选择。

针对你提到的“本地 WP 部署 + API 推送 + Vercel Web 应用”的设想,我们可以从数据流向、实现方案、核心优缺点三个维度来深度拆解:

核心架构设计

在传统的 Headless 架构中,通常是前端去“拉取 (Pull)”数据;而你提到的“推送 (Push)”模式,在配合 Vercel 的静态生成(SSG)时尤为高效。

1. 数据流向与工作原理

  • 本地环境(WordPress):你在本地(或内网/特定服务器)编写文章、上传媒体、配置自定义字段(ACF)。
  • 触发推送(Webhook):当你在本地点击“发布”或“更新”时,WordPress 通过插件触发一个 Webhook。
  • 云端接收与构建(Vercel):Webhook 或者是直接调用 Vercel 的 Deploy Hook 触发前端重新构建,或者是触发前端的 ISR (Incremental Static Regeneration,增量静态再生) 接口。
  • API 数据消费:Vercel 上的 Web 应用通过 WordPress REST API 或 GraphQL (WPGraphQL) 请求最新的内容数据,生成静态 HTML 并分发到全球 CDN。

核心实现方案

要实现这个架构,主要有两种技术路线:

方案 A:GraphQL 路由(推荐)

  • WP 端:安装 WPGraphQL 插件(比自带的 REST API 更适合前端按需索取数据)以及 ACF(用于复杂的模块化积木式排版)。
  • 触发端:使用 WPDeployer 或 JAMstack Deployments 插件。当文章保存时,自动请求 Vercel 的 Deploy Hook。
  • Vercel 端(以 Next.js 为例):配置 getStaticProps 或使用 App Router 的 fetch(..., { next: { revalidate: 3600 } })。

方案 B:纯静态全量推送

如果本地 WP 无法暴露给外网(比如完全在 Localhost 且没有做内网穿透),Vercel 在构建时是无法直接访问你的本地 API 的。这时候需要改变策略:

  • WP 端:安装 Simply Static 或 WP2Static 插件。
  • 推送模式:这些插件可以直接将 WordPress 导出的纯 HTML/JSON 静态文件,通过 API 直接推送到 GitHub 仓库。
  • Vercel 端:GitHub 代码一变动,Vercel 自动联动部署。

这种架构的利与弊

优势(Why we love it)

  • 极致的访问速度与 SEO:前台全静态化,Vercel 边缘网络(CDN)秒开,对排版画质要求高的站点极其友好。
  • 绝对的安全与低成本:WordPress 放在本地或隐藏在内网,黑客根本找不到攻击入口(彻底免受 WP 漏洞扫描侵害)。前台承受再大流量,本地 WP 也不受影响。
  • 无与伦比的设计自由度:摆脱了 WordPress 主题和传统页签构建器的束缚。前端可以用 Tailwind CSS 轻松实现像素级的极简现代主义排版、细腻的微动效以及丝滑的静态页面切换。

⚠️ 面临的挑战与应对策略

  • 本地图片的宿主问题:
    • 痛点:如果 WP 在本地,图片直接上传,Vercel 部署时图片路径会指向 localhost,导致线上图片碎裂。
    • 解法:必须使用云存储。本地 WP 需配置插件(如 OSS / S3 / Cloudinary 插件),确保所有媒体文件在上传时直接进入云端,WP 数据库里记录的是 CDN 绝对路径。
  • 预览功能(Preview)受限:
    • 痛点:在传统 WP 中,点击“预览”就能看到样式。在本地 Headless 架构中,本地点击预览无法直接看到 Vercel 上的真实效果。
    • 解法:需要利用 Next.js 的 Preview Mode,结合 WPGraphQL Router 配置一个专门的预览通道,或者在本地也跑一个前端的 Dev 实例。
  • 动态功能失效:
    • 痛点:WP 原生的评论、表单、搜索功能由于前端分离而无法直接使用。
    • 解法:评论改用 Disqus/Waline,表单改用 Formspree / Typeform,搜索改用 Algolia,走全栈 Serverless 化路线。

总结建议

这种“后台归后台,前台归前台”的解耦思路非常前沿。如果你准备付诸实践:

  1. 如果本地 WP 不做内网穿透,建议走 WP2Static 导出静态文件推送到 GitHub -> Vercel 的路线。
  2. 如果本地 WP 通过 LocalTunnel/Cisco AnyConnect/花生壳等做了穿透,或者部署在私有轻量服务器上,建议走 Next.js (ISR) + WPGraphQL 的标准无头路线,体验最为丝滑。

在本地网络完全不做穿透的前提下,前端选择 Next.js 绝对是一个非常扎实且上限极高的选择。

Next.js 的生态极其强大,尤其是它对 SSG(静态站点生成) 和现代前端构建流的支持,非常适合用来配合你的“孤岛式”本地 WordPress。

不过,在“无穿透”的特殊物理限制下,我们需要对数据流的交互方式做一些精妙的调整。以下是 Next.js 在这种场景下的核心运转逻辑、面临的挑战以及最佳实践:

无穿透场景下,Next.js 的两种运行模式

因为 Vercel 部署在云端,它在构建时无法突破内网来访问你电脑上的 localhost:8000(WordPress API)。所以,你不能使用 Next.js 常规的“云端实时拉取”模式。你得倒过来,让本地主动发起动作。

模式 A:本地构建 + 全量推流(极力推荐,最省心)

这是最适合无穿透、且能完美发挥 Next.js 静态极致性能的方案。

[本地 WordPress] 
      │ (编辑/更新内容)
      ▼
[本地 Next.js 源码] ──(本地执行 next build)──> [生成 Out 纯静态目录]
                                                     │
                                                     ▼
                                          [Git Push 推送到 GitHub]
                                                     │
                                                     ▼
                                            [Vercel 自动化部署]
  • 工作原理:
    1. 你的 Next.js 项目源码和 WordPress 都在你本地电脑上。
    2. 当你在本地 WP 改完内容后,在本地终端运行 npm run build(配置为 output: 'export' 静态导出模式)。
    3. 此时,Next.js 在你本地本地直接请求 localhost 的 WP API,把所有页面生成为纯静态的 HTML/CSS/JS。
    4. 构建完成后,通过 Git 推送到 GitHub,Vercel 收到代码变动,直接秒级分发到全球 CDN。
  • 为什么好:构建压力全在本地,Vercel 只负责托管静态文件,速度极快,且完全不需要配置任何 Webhook 和内网穿透。

模式 B:内容打包成 JSON 随代码同步

如果你希望构建过程依然发生在 Vercel 云端,可以采用“内容数据库代码化”的思路:

  • 工作原理:
    1. 本地 WordPress 安装导出插件(如 WP2Static 或利用 WP REST API 写个简单脚本),将所有文章和页面一键导出为一堆 .json 数据文件,保存到 Next.js 项目的 /data 文件夹内。
    2. 本地直接提交代码(包含这些 JSON 文件)到 GitHub。
    3. Vercel 在云端触发构建,Next.js 的 getStaticProps 或 App Router 不去请求 API,而是直接 fs.readFile 读取本地的 JSON 文件来渲染页面。
  • 为什么好:可以享受 Vercel 云端构建的便利,同时 JSON 文件还能作为你网站内容的历史版本备份。

避坑指南:Next.js 在该场景下的核心痛点

决定用 Next.js 后,有两点你在写代码和配置 WP 时必须提前处理:

1. 图片与媒体文件(必须上云)

由于本地没有穿透,Next.js 自带的 <Image /> 组件如果去引用 http://localhost/wp-content/uploads/... 的图片,线上必然碎裂。

  • 解法:在本地 WP 中安装 Cloudinary、AWS S3 或 阿里云 OSS 等插件。让所有上传的图片自动同步到云端,并在数据库中将图片地址替换为云端 CDN 地址。这样 Next.js 拿到的就是绝对路径的线上图片。

2. 必须关闭/替代动态功能

Next.js 的 SSR(服务端渲染)和 ISR(增量静态再生)在无穿透情况下会失效(因为云端找不到本地 API 无法动态刷新)。

  • 解法:全面拥抱 SSG(静态导出)。在 next.config.js 中配置:JavaScriptconst nextConfig = { output: 'export', // 开启纯静态导出模式 images: { unoptimized: true, // 静态导出模式下需禁用 Next.js 的默认图片优化 }, };
  • 至于评论、搜索等功能,前台直接用 JS 调用第三方 Serverless 服务(如 Algolia 搜索、Cusdis/Waline 评论)即可。

为什么 Next.js 比 Astro 或其他框架更适合?

  1. 像素级视觉掌控力:Next.js 与 Tailwind CSS 以及 Framer Motion(动画库) 的结合是天衣无缝的。对于你追求的极简现代主义、大字报排版(Swiss Style)以及细腻的转场动效,Next.js 的组件化开发体验能做到绝对的像素级精准还原。
  2. 未来可扩展性:如果有一天你决定把 WordPress 搬到线上(比如买了个便宜的云服务器),你只需要把 Next.js 的 output: 'export' 删掉,几分钟内就能无缝升级成支持 ISR(动态增量发布) 的现代无头站点,完全不需要重构前端代码。

总结: 本地无穿透,用 Next.js 做本地构建静态导出(SSG)后推送到 Vercel 是非常聪明且高级的打法。你既享受了 WordPress 强大的后台内容管理(积木式拼装布局),又得到了 Next.js 极致的前端视觉和极致的加载速度。

Vercel 部署架构规:AI Prompt Web应用

请做一个vercel 部署的应用架构的规划

1、业务应用:作为AI 生图的Prompt web应用,方便用户快速索引找到自己需要的的提示词
2、代码文件我们计划放在GitHub上
3、无数据库的设计,资源读取,我们采用文件夹的形式,一个文件夹代表一个分类,里面包含json、图片目录

以上,是否有补充的,评估下,然后给出最终执行方案

这是一个非常经典、轻量且高效的 JAMstack(JavaScript, APIs, and Markup) 架构。针对你的业务场景(AI生图提示词索引),“无数据库+纯文件驱动” 的设计非常适合前期的快速交付和零成本维护。Vercel 配合 GitHub 可以天然地将这些静态资源转化为全球加速的 API 或网页。

在给出最终执行方案前,我先为你做个架构评估,并补充几个在实际开发中你一定会遇到的隐性坑点与优化建议。

一、 架构评估与关键补充

1. 资源读取的性能瓶颈(核心补充)

  • 痛点:如果直接让前端(如 Next.js 客户端)去 GitHub 仓库里一层层读取文件夹和 JSON,会触发 GitHub API 的频率限制(Rate Limit),且速度极慢。
  • 解决方案:在构建时(Build Time)处理。利用 Next.js 的 getStaticProps(Pages 路由)或 GenerateStaticParams(App 路由)。在 Vercel 部署编译的那一刻,用 Node.js 的 fs(文件系统)读取本地文件夹,直接生成静态 HTML 和 JSON 缓存。这样用户访问时就是秒开,且不依赖任何外部请求。

2. 图片资源的托管优化

  • 痛点:GitHub 单个仓库有 1GB–5GB 的推荐上限,且单个文件超过 50MB 无法提交。如果你的 AI 生图提示词包含大量高分辨率效果图,仓库会迅速膨胀,且 Vercel 的图片优化额度(Image Optimization)在免费版是有上限的。
  • 解决方案:
    • 前期/轻量:图片直接放 GitHub 对应文件夹,前端利用 Vercel 自带的 next/image 进行 WebP 格式化(注意控制免费额度)。
    • 进阶/多图:如果后续有几千张图,建议将图片放到 Cloudinary 或 Vercel Blob / Cloudflare R2 等 Object Storage 中,GitHub 的 JSON 里只存图片的 URL 字符串。这样代码仓库会极其轻量。

3. 全局搜索与索引

  • 痛点:没有数据库,怎么做多维度搜索(按关键词、标签、模型检索)?
  • 解决方案:在构建时,顺便生成一个总的 search-index.json。前端加载页面时异步下载这个几十 KB 的索引文件,利用 FlexSearch 或 Fuse.js 在浏览器本地(Local)做纯前端的模糊搜索,体验会极度丝滑。

二、 最终执行方案

基于你的需求与上述优化,推荐采用 Next.js (App Router) + Tailwind CSS + GitHub + Vercel 的全栈静态化方案。

1. 目录结构设计 (Repository Structure)

在 GitHub 仓库中,将数据源与业务代码分离,规范化文件夹命名:Plaintext

my-prompt-app/
├── src/                    # Next.js 业务代码
│   ├── app/                # 页面路由 (首页、分类页、详情页)
│   └── components/         # UI 组件 (卡片、搜索框、复制按钮)
├── public/                 # 静态资源 (Logo 等)
└── data/                   # 💾 你的提示词数据库 (纯文件)
    ├── midjourney/         # 分类文件夹 A
    │   ├── index.json      # 该分类下的提示词列表与元数据
    │   └── images/         # 该分类下的效果图目录
    │       ├── cyberpunk-city.jpg
    │       └── anime-girl.jpg
    └── stable-diffusion/   # 分类文件夹 B
        ├── index.json
        └── images/

📄 data/midjourney/index.json 结构示例:JSON

[
  {
    "id": "mj-001",
    "title": "赛博朋克霓虹街道",
    "prompt": "Cyberpunk city street, neon lights, rainy night, unreal engine 5 render, 8k --ar 16:9",
    "tags": ["Sci-Fi", "City", "Night"],
    "image": "/data/midjourney/images/cyberpunk-city.jpg"
  }
]

2. 技术栈选型 (Tech Stack)

模块选型理由
前端框架Next.js 14+ (App Router)Vercel 的亲儿子,对静态文件读取(SSG)和图片优化支持完美。
样式框架Tailwind CSS现代、极简、高效率,便于快速构建现代社论感(Modern Editorial)或瑞士主义(Swiss Style)的极简网格布局。
本地搜索Fuse.js纯前端轻量级模糊搜索,无需后端支持。
UI 组件库Shadcn UI / Radix UI保持界面的高级感与原子化控制。

3. 核心开发逻辑 (Data Fetching)

利用 Next.js 的文件系统读取能力,在服务端(构建时)把文件夹转化为页面。

路径:src/app/page.tsx(首页:读取所有分类和提示词)TypeScript

import fs from 'fs';
import path from 'path';

// 定义数据结构
interface PromptItem {
  id: string;
  title: string;
  prompt: string;
  image: string;
}

async function getPromptsData() {
  const dataDirectory = path.join(process.cwd(), 'data');
  const folders = fs.readdirSync(dataDirectory);
  
  let allPrompts: PromptItem[] = [];

  folders.forEach((folder) => {
    const jsonPath = path.join(dataDirectory, folder, 'index.json');
    if (fs.existsSync(jsonPath)) {
      const fileContents = fs.readFileSync(jsonPath, 'utf8');
      const jsonData = JSON.parse(fileContents);
      allPrompts = [...allPrompts, ...jsonData];
    }
  });

  return allPrompts;
}

export default async function HomePage() {
  const prompts = await getPromptsData();
  
  return (
    <main className="p-8 max-w-7xl mx-auto">
      <h1 className="text-3xl font-bold mb-8">AI Prompt HUB</h1>
      {/* 提示词网格布局 */}
      <div className="grid grid-cols-1 md:grid-cols-3 gap-6">
        {prompts.map((item) => (
          <div key={item.id} className="border rounded-lg overflow-hidden bg-card">
            <img src={item.image} alt={item.title} className="w-full h-48 object-cover" />
            <div className="p-4">
              <h3 className="font-semibold text-lg">{item.title}</h3>
              <p className="text-sm text-muted-foreground mt-2 line-clamp-2">{item.prompt}</p>
              {/* 一键复制按钮组件 */}
            </div>
          </div>
        ))}
      </div>
    </main>
  );
}

4. 部署与工作流 (Deployment Workflow)

  1. 初始化:在本地初始化 Next.js 项目,按照上述结构放入第一批测试文件夹、JSON 和图片。
  2. 托管:将代码推送到 GitHub 私有或公开仓库。
  3. 部署:
    • 登录 Vercel,点击 Import Project,选择该 GitHub 仓库。
    • Framework Preset 选择 Next.js。
    • 点击 Deploy。
  4. 日常更新工作流(重点):
    • 当你需要上新提示词时,不需要动代码。
    • 直接在本地(或通过 GitHub 网页端)在 data/ 下新建一个文件夹,丢入图片,改好 index.json。
    • git commit -m "feat: add new cyberpunk prompts" 并 git push。
    • Vercel 会自动捕获这次 push,触发自动构建(Webhook),在 1 分钟内将新提示词编译并发布上线。整个过程实现自动化,GitHub 此时既是你的“代码库”,也是你的“CMS(内容管理系统)”。

这个方案完全在 Vercel 的免费额度(Hobby Plan)内即可完美运行,访问速度极快,且具备极强的可扩展性。你觉得这个执行方案是否符合预期?如果有需要调整的细节(例如界面风格偏好或特定功能),我们可以进一步细化。

你的提示词都是在“许愿”

大多数提示词合集都很泛泛。”帮我写一篇博客。””总结这段文字。””解释这个概念。”

那不叫提示词。那叫许愿。

一个真正的提示词是一套精心设计的指令,它能产出稳定、高质量、直接可用的结果——不管你用哪个模型。它包含了角色、上下文、约束条件、格式、质量标准,以及具体的示例。

这 40 个提示词在 Claude、ChatGPT 和 Gemini 上都能用。三个平台全部验证过。复制即用,无需修改。

按场景分类。标注了难度。建议先收藏再细读。

第一部分:写作与内容创作(01-10)

写作是 AI 最高频的使用场景,也是差距最大的场景。90% 的人用 AI 写出来的东西一眼就能看出来是 AI 写的——空洞、啰嗦、没有观点。剩下的 10% 用的就是下面这类提示词。

01. 专家级文章写手

你是一位曾为顶级媒体撰稿的资深内容策略师。请写一篇 [字数] 字的文章,主题:[话题]。目标读者:[他们是谁、他们知道什么]。切入角度:[你的独特主张——让这篇文章区别于同一话题下的所有其他文章]。结构:开头钩子:从一个大胆的主张或令人惊讶的事实开始。不允许泛泛的开场白。 问题:为什么当前对这个话题的认知是错误或不完整的。 框架:用 3-5 个有名称的章节呈现你的论点,每章有明确的小标题。 证据:每个章节包含一个具体的例子、案例研究或数据点。 行动:以读者本周就可以做的 3 件具体事情结尾。 规则:每段最多 3 句话 不使用填充语(”值得注意的是”、”在当今世界”) 不使用模糊措辞(”可能”、”似乎”、”某种程度上”) 每个论断必须具体,不能含糊 加粗每个章节中最重要的一句话 这篇文章应该达到不加修改就可以直接发布的标准。

使用建议: 这个提示词的灵魂在于「切入角度」那一步。不要写”关于 AI 对教育的影响”,而写”AI 不会替代老师——但会替代那些不会用 AI 的老师”。没有角度,就没有观点。没有观点,就只是一堆信息的重组,不是一篇文章。

02. 推特长帖架构师

写一个关于 [话题] 的 Twitter/X 长帖。长帖结构:第 1 条:钩子。大胆的主张、令人惊讶的数据、或反常识的观点。必须在 2 秒内让人停下滑动。 第 2-3 条:问题。为什么大多数人对这件事的认知是错的。 第 4-10 条:框架。编号的步骤、技巧或洞察。每条一个。每条既要能单独成立、又要在序列中自然衔接。 第 11-12 条:真实案例或案例研究,证明这个框架有效。 最后一条:一个可执行的要点 + 行动号召。 规则:每条不超过 280 个字符 不加标签 只有能增加含义时才用 emoji 不写”让我解释一下”、”事实上是这样的”——每条开头就是实质性内容 整体感觉应该是跟一个聪明的朋友学习,而不是读教科书 总计:12-15 条。

使用建议: 长帖的成败取决于第一条。如果第一条让人划过去了,后面写得再好也没人看到。所以第一条要花最多的精力打磨——一个反常识的观点、一个让人停下来的数据、一个直接击中目标读者的痛点。

03. 邮件撰写器

为以下情境起草一封邮件:[描述情境、收件人和你的目标]。语气:[专业/轻松/直接/外交]。规则:邮件标题:具体且行动导向(不要写”有个问题”或”跟进一下”) 开头:第一句话就直接说事。不写”希望这封邮件能找到你”。 正文:最多 3 个短段落。每个段落服务一个目的。 结尾:明确的下一步或请求。收件人应该清楚知道你要他们做什么。 总长度:150 词以内。 生成两个版本:版本 A:[语气 1——如直接果断]、版本 B:[语气 2——如温暖合作]。

使用建议: 150 词以内的限制是精髓。大多数人的邮件有 60% 的内容是废话——寒暄、铺垫、客气。砍掉这些,邮件回复率会明显上升。对方向你发送了一封需要决策的邮件,你回一个 500 词的邮件他反而更不想回了。

04. 内容多平台分发器

将以下内容改写成 5 种格式: <原始内容>[粘贴你的文章/帖子/转录]</原始内容>创建:Twitter/X 长帖(12 条,每条 280 字以内) LinkedIn 帖子(200-300 词,专业但不说教) 邮件通讯导语(100 词,引发对完整内容的好奇) 3 篇独立社交媒体帖子(每篇自包含,各突出一个不同洞见) 短视频脚本(60 秒,对话感,设计成对着镜头说) 规则:每种格式应该像是该平台原生内容,而不是复制粘贴 在所有格式中保持核心论点和关键洞察一致 按平台调整语气:X = 精炼直接,LinkedIn = 专业有深度,邮件 = 个人化、独家感

使用建议: 这是一篇长文 = 一周所有平台内容的秘密配方。周一花 30 分钟让 AI 跑完这个提示词,剩下 6 天定时发布。不要每条都重写——一次输出,多次复用。

05. 文案转化改写器

把这段文字改写得更具说服力: <原文>[粘贴文字]</原文>应用以下文案原则:先说好处,而不是先说功能 用具体数字替代模糊表述 在读者产生疑虑之前就主动化解 创造紧迫感,但不用操纵手法 以清晰、低门槛的行动号召结尾 展示改写后的版本,然后解释你做的 3 个最有影响力的修改,以及每个修改为什么在心理上有效。

使用建议: 最后那句”解释为什么有效”是这个提示词最有价值的部分。它不只是帮你改写——它在教你文案。每次用都是在免费上课。改写的效果你今天就能用,解释的原理你可以用一辈子。

06. 博文大纲生成器

为一篇关于 [话题] 的博文创建详细大纲。目标读者:[谁]。目标:[读者读完后应该做什么/感受到什么/理解什么]。目标长度:[字数]。每个章节提供:标题(有吸引力、具体、不泛泛) 2-3 句话概括本章内容 本章需要包含的关键数据、例子或论点 到下一章的过渡 同时包含:3 个备选标题选项(按预测点击率排序) 建议的 Meta 描述(160 字符以内) 5 个内链/外链机会推荐

使用建议: 这是内容团队的效率翻倍神器。不应该是”我写完了草稿再想想标题和 SEO”,而是”我在动笔之前大纲里已经有标题、Meta 描述和链接策略”。顺向流程的效率远远高于逆向修补。

07. 故事化转换器

把这段枯燥的事实性信息转化为一个有吸引力的叙事: <事实>[粘贴枯燥的事实、数据或技术内容]</事实>规则:从一个具体场景、人物或瞬间开始——不是从定义开始 把事实编织进一个故事弧线:铺垫 → 张力 → 解决 用类比让复杂概念变得直观易懂 包含一个”顿悟时刻”——读者的理解发生转折的那个点 以一个能将故事连接回读者生活的收获结尾 保持事实准确。改变的是表达方式,不是真相。

使用建议: 这是最有价值的提示词之一。数据告诉人,故事打动人。你用数据写的方案对方会看,你用故事讲的方案对方会记住。任何时候你想传递一个干巴巴的信息,先跑这个提示词。

08. 标题生成器

为以下内容生成 20 个标题选项:[简要描述内容]分类:5 个好奇心驱动的标题(让人必须点进去看看) 5 个利益驱动的标题(让人立刻看到价值) 5 个反常识标题(挑战读者目前的认知) 5 个具体数字标题(使用精确的数量或时间) 对每个标题,用 1-10 分评估其预测点击率并解释原因。给出你的 Top 3 排名及理由。

使用建议: 别挑你觉得最好听的。挑目标受众最可能点的那一个。这是两种完全不同的判断方式。如果拿不准,拿去问 AI:”如果你是 [目标受众],看到这 3 个标题你会点哪个?为什么?”

09. 案例研究构建器

将以下零散事实转化为有说服力的案例研究: 客户:[名称/类型] 问题:[他们遇到了什么问题] 解决方案:[实施了什么] 结果:[可衡量的成果]结构:挑战(2 段——让读者感受到痛苦) 方法(3-4 段——具体步骤,不是泛泛的描述) 结果(1-2 段——具体数字,前后对比) 关键收获(1 段——对读者有意义的教训) 引语(一句客户真的可能会说的话,基于结果来写) 规则:使用现在时增加临场感 包含至少 3 个具体数字 引语要让人感觉真实,不要像营销文案

使用建议: 案例研究是 B2B 领域转化率最高的内容形式,没有之一。但大多数人写不好——要么太干(全是数据像报告),要么太软(全是溢美之词像广告)。这个提示词给出的结构是经过验证的:先让人感受到”我也有这个问题”,再展示”原来可以这样解决”,最后用具体的数字和一句人话收尾。

10. 风格模仿器

分析同一作者的这 3 个写作样本: <样本_1>[粘贴]</样本_1> <样本_2>[粘贴]</样本_2> <样本_3>[粘贴]</样本_3>识别:句子长度模式(短句、混合、长句) 词汇水平(简单、技术性、混合) 语气(正式、随意、权威、对话式) 结构习惯(段落长度、标题使用、列表模式) 标志性短语或反复出现的模式 他们始终避免的东西 然后写一篇 300 词的关于 [新话题] 的文章,与这位作者的风格完全一致。读者应该以为这是原作者写的。

使用建议: 这个提示词的最高频场景不是”模仿别人”,而是”模仿自己”。把你的 3 篇代表作喂给 AI,让它提炼你的风格模型。以后写出来的东西就天然带你的味道。AI 是你的扩写器,而不是你的替代者。

第二部分:分析与策略(11-20)

写作搞定的是表达。分析和策略搞定的是思考。下面这 10 个提示词,让 AI 帮你做结构化思考——不是你问一句它答一句,而是它按一套完整的方法论来分析问题。

11. SWOT 分析器

对 [公司/产品/战略] 进行全面 SWOT 分析。对每个象限(优势、劣势、机会、威胁):列出 5 个具体事项(不是泛泛的——与当前具体情境相关) 对每个事项:用一句话解释为什么它属于这个象限 评估每个事项的影响:高/中/低 然后提供:基于此分析的首选战略重点(一句话) 如果忽略这个重点,最大风险是什么(一句话) 本周要采取的第一个行动(一个具体、可执行的步骤)

使用建议: SWOT 的关键不是填满四个格子,而是最后那三个问题的答案。大多数 SWOT 做完后没人看,因为只有分析没有行动。这个提示词强制输出行动项。

12. 决策矩阵

我需要在以下选项之间做决定:[列出 2-4 个选项] 背景:[相关背景——预算、时间表、团队、目标]构建决策矩阵:识别出这个决策中最重要的 5 个标准(如果你不确定就问我) 按重要性对每个标准赋权重(加起来必须等于 100%) 针对每个标准给每个选项打分(1-10) 计算加权得分 以格式化表格呈现 然后写出 2 段的建议:明确说明选择哪个选项及理由 承认第二名选项的最强理由 指出哪个条件变化会让建议改变

使用建议: 人在决策时最大的问题不是一个选项明显好于另一个——那种不需要算。真正让你纠结的决策,通常几个选项打成平手。决策矩阵的作用不是”算出答案”,而是把隐性的权衡显性化。你一看那个表格,就知道自己内心的天平其实已经偏向了哪一边。

13. 根因分析器

我面临一个问题:[描述问题及其症状]进行根因分析:依次追问”为什么?”5 次(5 Whys 方法),每次往更深层挖 每一层判断这是症状还是根因 在最深层级,识别出真正的根因 提出 3 个解决方案——一个针对表面症状、一个针对中层原因、一个针对根本原因 给出建议:应该实施哪个方案、为什么 不要假设我对问题的初步描述就是对的。真正的问题通常不是我描述的那个。

使用建议: 这个提示词里最有价值的一句话是最后那句——”不要假设我对问题的初步描述就是对的”。人类描述问题的水平很差。你说”我没办法专注”——可能是你手机在旁边,也可能是你对在做的事根本不感兴趣,也可能是你睡眠不足。你描述的是感受,不是原因。AI 的”5 Whys”会一层层剥开。

5 Whys 示例:

  1. 为什么没按时交付?→ 因为开发进度延迟了
  2. 为什么开发进度延迟?→ 因为需求中途改了三次
  3. 为什么需求会改三次?→ 因为评审会上客户方决策人没来
  4. 为什么评审会决策人没来?→ 因为没人提前确认他的时间
  5. 为什么没人确认时间?→ 因为没有项目启动前的干系人确认流程

从”开发太慢了”到”我们需要一个干系人确认流程”——这就是 5 Whys 的价值。

14. 市场机会扫描器

分析 [产品/服务创意] 的市场机会。评估:需求:谁想要这个?有多少人?你怎么知道他们想要? 竞争:还有谁在做?他们收多少钱?他们的弱点在哪里? 时机:为什么是现在?有什么变化让这件事在今天可行而在以前不行? 护城河:有什么能阻止竞争对手在 6 个月内复制你? 单位经济模型:单个客户交付成本 vs 可能收费是多少? 每个部分:要具体、尽量用数字、标注你不确定的任何信息。以 GO / 谨慎 GO / NO GO 的建议结束,并给出你的置信度(高/中/低)。

使用建议: “时机”那个问题是真正的杀手锏。大部分创业想法不是想法本身有问题,是进来得太早或太晚。”有什么变化让这件事在今天可行”——AI 工具的出现让一个人也能做以前需要团队才能做的事?政策变化?技术成本下降?如果你回答不了这个问题,你还没有真正理解自己的机会。

15. 会议策略师

我有一个关于 [话题] 的会议,对象是 [谁——他们的角色、与你的关系、他们在乎什么]。我在这场会议中的目标:[你想要达成的结果]。准备:开场白(2 句话——为对话设定正确的框架) 我必须传达的 3 个关键点(按优先级排序) 我应该问的 3 个问题(从最重要到最不重要排序) 对方可能提出的 3 个异议及我的回应 理想结束语(总结共识和下一步) 底线:我可接受的最低结果是什么?

使用建议: 大多数人准备会议的方式是”我大概知道我要说什么”。这个提示词逼你在会前写出来——不只是你要说什么,还有对方可能说什么、你的底线在哪。第 4 项和第 6 项是决定会议成败的关键。没有预判异议就进会议 = 裸奔。没有想好底线就进谈判 = 你不知道自己在哪一步输了。

16. 定价策略师

帮我为 [产品/服务] 制定定价方案。背景:它做什么:[描述] 目标客户:[目标客户] 交付成本:[你的成本] 竞品定价:[竞品价格,如已知] 交付的价值:[客户获得什么——节省的时间、赚到的钱、解决的问题] 设计定价结构:三个梯次(入门、核心、高级),用反映价值的名称,不是大小 每个梯次包含什么,以及为什么在这些地方设置分界 每个价格点背后的心理逻辑 大多数客户应该在哪个梯次落地,以及如何引导他们到那里 一次性 vs 订阅分析——哪种模式更合适,为什么 以格式化对比表格展示定价方案。

使用建议: “哪个梯次大多数客户应该落地”和”如何引导他们到那里”是定价策略中最被低估的两个问题。中间的梯次是你的利润引擎——定价太低你活不下去,定价太高没人进来。中间梯次的设计要把”稍微加点钱就能多拿很多价值”的逻辑做到最明显。

17. 竞品拆解

对 [竞品名称/网址] 进行竞品拆解。分析:定位:他们的核心信息是什么?他们的目标客户是谁?他们在卖什么情感? 产品:他们实际提供什么?核心功能 vs 锦上添花的功能? 定价:他们怎么收费?每个梯次包含什么?利润在哪里? 内容:他们发布什么话题?频率?什么格式表现最好? 弱点:他们在哪里脆弱?他们的客户抱怨什么?他们没有在做什么? 以”如果我要和 [竞品] 正面竞争,我会做的 3 件不一样的事是……”结束。

使用建议: 最后一个问题才是这个提示词的目的。前面 5 个分析都是为了回答那 3 件不一样的事做铺垫。如果你的答案没有指向”他们漏掉了什么”或”有一群人他们没服务好”,那你就在做一模一样的产品——而一模一样的产品只能靠拼价格赢,那是最差的赢法。

18. OKR 构建器

帮我为 [团队/个人/公司] 制定 [时间段] 的 OKR。背景:[当前状况——我们在哪里、想去哪里、有什么资源]对每个 Objective(建议 3 个):Objective:有雄心但可实现、定性描述、能激励人 3-4 个 Key Results:具体、可衡量、有时间限制 对每个 Key Result:当前基线、目标值、衡量方式 可实现置信度(1-10 分):该 Key Result 在时间范围内是否可达 标注可能相互冲突的 Key Results。

使用建议: 最后一句”标注可能冲突的 KR”是最容易漏掉的关键。你设定了一个”发布 3 个新功能”和”客户 NPS 提高 10 分”的 KR——这两个可能是冲突的,因为发布了没经过充分打磨的功能反而会拉低 NPS。冲突检测让你的 OKR 从”愿望清单”变成”真正的战略对齐”。

19. 风险评估器

我即将 [描述项目/决策/计划]。进行风险评估:列出最可能出现的 7 个风险(可能出问题的地方) 对每个风险:概率:高/中/低 如果发生,影响大小:高/中/低 早期预警信号(我怎么发现这个风险正在变成现实?) 缓解策略(我做什么来预防它发生?) 应急预案(如果真的发生了我怎么办?) 画一个 2×2 矩阵把风险分类(概率 vs 影响) 指出我应该主动监控的前 3 大风险 悲观一点。我想听到的是我没有考虑到的风险,而不是安慰我一切都会好的。

使用建议: 倒数第二句是这个提示词的秘密——”悲观一点”。大多数人在让 AI 评估风险时,AI 默认输出是中性的、圆滑的、不得罪人的。但风险评估的价值恰恰在极端情况。”这事可能 90% 不会发生,但如果发生了就完了”——你需要的正是对那 10% 的认真对待。

20. 复盘引导师

引导这个项目/时间段的复盘:[描述发生了什么]结构:什么做得好(找出 5 件确实有效的事,附证据) 什么出了问题(找出 5 件确实没效果的事,附根因) 我们学到了什么(3 个会改变我们未来工作方式的教训) 我们会做什么不同的事(3 个具体的、可执行的改变——不是模糊的意图) 我们会停止做什么(2 件我们应该刻意停止的事) 规则:必须具体。”沟通不好”是没用的。”产品团队在定价变动前 2 天才被通知,导致营销材料来不及更新”是有用的。 每个识别出的问题,包含一个具体的预防措施。

使用建议: 第 5 部分”停止做什么”是 90% 复盘里没有的。大家都在加——加流程、加检查、加文档。但没有人问”我们应该停止做什么”。真正让团队变高效的不是做得更多,是停止做那些已经不产生价值的事。这条规则的威力在于它强制你砍掉东西。

第三部分:技术与开发(21-28)

这一组是给写代码的人准备的。如果你不写代码,可以跳过去看第四部分。如果你写代码,这些提示词能替代你 60% 的”搜 Stack Overflow → 看文档 → 试 → 报错 → 再来一次”循环。

21. 架构顾问

我想搭建 [描述系统]。需求:[需求 1] [需求 2] [需求 3] 预期规模:[用户数/数据量] 预算限制:[任何限制] 提出 2 个架构方案。对每个方案:组件图(用文字描述——列出每个服务/模块及其连接方式) 技术选型和每个选择的理由 优缺点(诚实说明取舍) 预估复杂度:简单/中等/复杂 这个方案最可能出问题的那一件事 推荐一个方案。解释理由。然后给我前 5 步的实施步骤(按顺序)。

使用建议: “这个方案最可能出问题的那一件事”是照亮盲区的灯。每个架构方案都有一个阿喀琉斯之踵。在写第一行代码之前就知道它在哪里,比上线那天凌晨 3 点才发现要便宜一万倍。

22. 代码审查员

审查这段代码: [粘贴代码]检查以下方面:安全:注入漏洞、暴露的密钥、XSS、不安全的数据库处理 逻辑:未处理的边缘情况、错误的逻辑判断、差一错误 性能:N+1 查询、不必要的计算、遗漏的缓存机会 可读性:不清晰的命名、复杂逻辑缺少注释、过度嵌套 最佳实践:违反语言规范、缺少错误处理、未使用的导入 对发现的每个问题:严重程度:严重/高/中/低 精确位置(行号或函数名) 为什么这是问题(不只是哪里错了,而是可能导致什么后果) 修复方案(展示修正后的代码) 如果代码本身没问题,就说没问题。不要为了显得全面而编造问题。

使用建议: 最后那句”如果没问题就说没问题”是关键。很多人在审查时忍不住要找点问题出来——不管是人还是 AI。但这会让审查失去可信度。好的审查像好的安检:有问题必须拦住,没问题快速放行。每一次”没问题”的反馈都在积累信任。

23. Debug 诊断器

我遇到这个错误:[粘贴完整的错误信息和堆栈回溯] 上下文:[这段代码应该做什么]不要立刻跳到修复方案 首先:用日常语言解释这个错误消息是什么意思 其次:按概率从高到低列出 3 个最可能的根因 第三:对每个可能原因,解释什么样的证据可以确认它 第四:在确定根因后,展示修复方案 第五:解释什么措施可以避免这类 bug 在将来再次出现 [粘贴相关代码]

使用建议: 步骤 1 “不要立刻跳到修复方案”是反人性的——人类遇到 bug 的第一反应就是试各种修法。但这是最低效的调试方式。理解错误→提出假设→验证假设→修复→预防。这套流程让每一次 bug 修复不只是修了一行代码,而是在你的知识体系里补了一个洞。

24. API 设计器

为 [描述系统/功能] 设计 REST API。对每个端点:方法和路径(遵循 REST 规范) 请求体 Schema(标注必填/可选字段) 响应体 Schema(成功和错误情况) 鉴权要求 速率限制建议 同时包含:错误响应格式(所有端点统一) 列表端点的分页方案 版本管理策略 3 个潜在安全问题及应对方案 以格式化 API 参考文档形式呈现。

使用建议: API 设计最难的不是”让功能跑通”,而是”一致性”。6 个月后新加入的工程师能不能不看文档就猜出这个 API 的写法和返回格式?这个提示词通过强制规定错误格式、分页方案、版本策略,让一致性从一开始就被内建到设计中。

25. 数据库 Schema 设计器

为 [描述应用] 设计数据库 Schema。需求:[列出关键实体和关系] 预期规模:[数据量和增长速度] 对每张表:列及其类型、约束、描述 主键和索引 外键关系 同时提供:实体关系描述(表之间如何连接) 该 Schema 必须高效支持的 3 个常见查询 支持上述查询的索引建议 一个潜在的性能瓶颈及应对方案 如果后期需求变化,如何进行迁移的策略

使用建议: “如果后期需求变化怎么迁移”是资深工程师和新手的分水岭。新手设计 Schema 只想”现在怎么存”。老手想的是”三个月后如果加一个 XX 功能,这个结构改起来痛不痛”。这个问题让 AI 帮你做完 Schema 设计的压力测试。

26. 测试用例生成器

为以下函数/功能生成完整的测试用例: <代码或描述>[粘贴代码或描述功能]</代码或描述>测试分类:正常路径:3 个正常预期使用的测试 边界情况:5 个边界条件、空输入、最大值的测试 错误情况:3 个无效输入、缺失数据、系统失败的测试 安全性:2 个注入尝试、未授权访问的测试 性能:1 个负载或大数据集下行为的测试 对每个测试:测试名称(描述性) 输入 预期输出 为什么这个测试重要

使用建议: 大部分自测文件写了 10 个”正常路径”测试,0 个”传了个负数进来怎么办”的测试。正常路径的测试告诉你代码能在晴天行驶。边界和错误的测试告诉你它会不会在下雨天翻车。用户的实际行为不是正常路径——用户会在输入框里塞一个富文本、传一个超长字符串、或者在网络断了的瞬间反复点按钮。

27. 文档撰写器

为以下代码/API/系统撰写开发者文档: <代码或规范>[粘贴代码或规格说明]</代码或规范>包含:概览(这个是什么、为什么存在——2-3 句话) 快速上手(5 分钟内跑起来) 核心概念(解释心智模型,不只是 API 表面) API 参考(每个公开函数/端点,包含参数、返回值、示例) 常见模式(3 个典型用法模式,附代码示例) 故障排除(5 个常见问题及其解决方案) 写给一个聪明但从未见过这个代码库的开发者看。

使用建议: 大多数文档的问题是:它写的是”这个 API 怎么用”,而不是”这个系统的思维模型是什么”。前者是字典,后者是地图。新来的开发者需要的是地图——告诉他系统是怎么想的,东西放在哪里、数据怎样流动。这个提示词的第三部分”核心概念”解决的问题就是:先给地图,再给字典。

28. 重构规划器

这段代码需要重构: [粘贴代码]分析:前 3 个代码质量问题是什么?(重复逻辑、职责混杂、不必要的复杂) 对每个问题:解释为什么这是一个问题,而不仅仅是”它存在” 提出重构方案,按顺序列出具体步骤 每步:展示重构前后的代码对比 验证重构后的代码保持了完全相同的外部行为 评估影响:这次重构对可维护性、可读性、可测试性有多大提升? 不要改变外部行为。只做内部改进。

使用建议: “不要改变外部行为,只做内部改进”是重构的铁律。这也是为什么重构需要测试覆盖——如果你没有测试,你就不知道你改完之后外部行为还一不一样。重构前先让 AI 给这段代码生成测试用例(用提示词 #26),重构后用同样的测试验证。

第四部分:生产力与个人效能(29-32)

29. 周计划制定器

以下是我这个季度的目标:[列出目标] 以下是我上周完成的事:[简要总结] 以下是我本周的承诺:[会议、截止日期、固定事项]创建我的周计划:最重要的 3 件事(对季度目标贡献最大的事) 日程安排(按天列出的会议和截止时间) 缓冲任务(重要但时间灵活的事) 刻意跳过(我本周选择不做的事以及原因) “刻意跳过”部分是最重要的。说”不”是优先事项之所以能是优先事项的原因。

使用建议: 你的周计划里如果没有”不做什么”,就等于没有排优先级。人的时间不是无限的——你说”这些都是优先”就等于”没有一个是优先”。刻意跳过的列表是你在对自己的时间说:我知道这件事也重要,但我选择不做它,因为那件事更重要。

30. 学习加速器

我想学习 [话题/技能]。当前水平:[初级/中级/高级]。可用时间:[每周多少小时]。学习风格:[实践/理论/混合]。目标:[学完后我能做什么]。创建学习计划:前置知识:我需要先知道什么?(如果我缺少基础,请诚实告诉我) 核心概念:必须掌握的 5-7 个关键概念,以及我应该按什么顺序学习它们 项目:对每个概念,一个能通过动手实践来掌握的练习项目 资源:对每个概念,最好的单一资源(不是 10 个选项——一个) 验证点:我怎么知道我真的理解了这个概念?(具体测试,不是”感觉熟悉了”) 时间线:基于我的可用时间,切合实际的按周学习计划 不要填满计划。如果我可以在 3 周内学会,不要拉长到 8 周。

使用建议: 第 4 点”每个概念只给一个最好资源”是这个提示词里最反人性的也最有用的设定。大多数人的学习方式是:收藏 30 个教程 → 打开 3 个 → 哪个都没看完 → 觉得自己学不会。单一最佳资源强迫你做选择、强迫你走到底。一本好书读三遍远好于三本书各读一章。

31. 谈判准备器

我即将跟 [谁] 谈判 [什么事]。背景:[相关背景——关系、历史、权力动态] 我的理想结果:[最好的情况] 我的可接受结果:[我能接受的最低限度] 他们的可能立场:[他们大概想要什么]准备:我的开局立场及背后的理由 我可以做出的 3 个让步(从最小到最大排序) 每个让步我应该要求对方回报的 3 样东西 对方最可能的 3 个异议及我的回应 2 个能给双方创造更多价值的创意选项(把饼做大) 我的离开底线,以及如果我需要优雅退出时使用的准确措辞

使用建议: “2 个能扩大蛋糕的创意选项”把谈判从零和博弈变成了合作创造。最好的谈判不是分 100 块钱——是找到办法让桌上变成 200 块。你帮对方省了时间、你能接受他们不在意的条款、你提供了一个他们想都没想过的交换条件。让 AI 帮你想这些创意选项——它不受你的利益立场限制。

32. 习惯设计器

我想培养这个习惯:[描述习惯]。我的日常作息:[典型的一天是什么样的]。过去的尝试:[以前试过什么、为什么失败了]。设计习惯实施方案:这个习惯的最小可行版本(2 分钟启动版) 触发点:我把它挂载到现有的哪个习惯或事件上? 环境设计:什么样的物理改变能让这个习惯更容易做? 奖励:什么即时正向反馈能强化这个习惯? 追踪方式:我怎么衡量连贯性? 失败协议:某天没做到时我应该怎么办?(因为我肯定会有一天没做到) 渐进:2 分钟版如何在 4 周内逐步成长? 现实一点。我宁愿培养一个能坚持下来的小习惯,也不愿设计一个完美的方案然后一周就放弃。

使用建议: “失败协议”是整个提示词里最重要的设计。养成习惯的敌人不是难度,是”断了一次就觉得自己失败了然后彻底放弃”。你需要提前写好在断掉一天之后该怎么办——是第二天直接继续、不需要补、不需要自我惩罚。这个协议的心理学本质是把”连续”偷换成”频率”。不是不能断,断一天不算失败,两天以上才算。

第五部分:数据与研究(33-35)

33. 数据解释器

分析以下数据: <数据>[粘贴数据——CSV、表格、数字、调查结果等]</数据>提供:汇总统计(关键数字一览) 最重要的 3 个模式或趋势 2 个不是一眼能看出来的令人惊讶的发现 1 个这个数据中可能被误读的地方(什么可能被错误地解读?) 3 个这个数据引发、但需要更多数据才能回答的问题 受众:[谁会读这份分析、他们的技术水平如何]先用日常语言讲清楚发现,再附上支撑数据。

使用建议: 第 4 点”可能被误读的地方”是所有数据分析里最被低估的输出。同样的数据,不同的人读出来完全相反的结论——相关不等于因果、平均值掩盖了分布的形状、百分比的基数变了。AI 帮你提前踩坑,让你的分析不是”自说自话”,而是经得起别人的挑战。

34. 调查分析器

分析这些调查结果: <调查数据>[粘贴调查回复]</调查数据>提供:受访者群体的关键人口统计/细分特征 按显著程度排名的前 5 个发现 共识区域(受访者在哪些地方高度一致) 分歧区域(观点在哪些地方出现分裂) 与普遍假设相矛盾、令人惊讶的发现 基于数据的可执行建议(3 件具体要做的事) 这个数据的局限性(样本量、偏差、我们无法得出的结论)

使用建议: 最后第 7 点的”数据局限性”是职业道德级别的要求。你做了一个 200 人的问卷调查,你不能说”全行业都这么认为”。标注局限性不是弱化你的结论——是你告诉读者”我知道我的边界在哪”。这恰恰在建立你的可信度。

35. 研究综合器

我从多个来源收集了关于 [话题] 的研究资料: <来源_1>[粘贴或摘要]</来源_1> <来源_2>[粘贴或摘要]</来源_2> <来源_3>[粘贴或摘要]</来源_3>综合:所有来源中的共同主题(它们在什么上面达成一致?) 矛盾点(在哪些地方意见有分歧?谁更可信、为什么?) 空白(哪些问题仍然没有答案?) 我可以确信的最重要的 3 个结论 我应该下一步研究什么来加强我的理解 不要只是把每个来源单独总结一遍。我需要真正的综合——跨来源的连接和规律,这些是单独阅读每份资料看不出来的。

使用建议: 最后一句”不是单独总结,而是跨来源的综合”是这个提示词的核心。大多数人的”文献综述”实际上是”文献堆砌”——A 学者说了 X,B 学者说了 Y,C 学者说了 Z。但读者真正想知道的是:这三个人合在一起告诉我什么?他们在哪里打架了?在哪里其实说的是一回事但用不同的词?合成 = 创造新信息。这个新信息在你喂进去的任何一份单独材料里都不存在。

第六部分:沟通(36-40)

沟通是最被低估的 AI 应用场景。大多数人用 AI 写文章、做分析、写代码——却忘了每天消耗最多心力的是跟人说话。尤其是那些难说的话。

36. 困难对话准备器

我需要跟 [谁——角色、关系] 进行一次困难的对话,关于 [话题]。情况:[发生了什么、为什么这次对话是必要的]。我的目标:[我想要达成的结果——不只是我想要说什么]。对方可能的反应:[我预期对方如何回应]。准备:开场白(直接但有同理心——不回避问题,但也不攻击对方) 核心信息用一句话(不管对话怎么展开,这条信息必须被传达) 如何应对防御性反应(针对性回应”这不公平” / “你错了” / 情绪化反应) 如何主动倾听(我该问什么问题来理解对方的视角) 如何达成解决方案(3 个可能结果,从最佳到可接受排序) 结束语(总结达成的共识、维护关系、明确下一步)

使用建议: 困难对话失败的最大原因不是你说错了话——是你之前没有想过对方可能怎么反应。第 3 点”如何应对防御性反应”就是提前预演最坏情况。当你说”我们需要谈谈你最近的三次延迟交付”时,对方不会说”谢谢你,你完全正确,我会改进”。人性不是这样的。对方会说”那个是因为 XX 部门没配合”或者”你已经很久没给过我优先级了”。如果你没有提前准备好这些回应,你就会当场被带偏或者被激怒——对话就此失败。

37. 反馈提供器

我需要给 [谁——角色、关系] 关于 [什么事——具体行为或工作] 的反馈。背景:[关系良好?反复出现的问题?还是第一次?]使用以下框架撰写反馈:观察(我具体观察到了什么——针对行为,不是人品) 影响(它如何影响了团队、项目或结果——具体,不模糊) 期望(我希望未来看到什么——具体且可达到) 支持(我会做什么来帮助他们成功——而不仅只是要求改变) 语气:[支持性/直接/严肃]。写成说出来的话,不是邮件。这是一次对话,不是一份备忘录。

使用建议: 这个框架叫 OIES——Observation / Impact / Expectation / Support。它的核心逻辑是:第 1 步”观察”在说”我看到了什么”,不是在说”你是个什么人”。把行为和人品分开,对方才有可能听进去。”你这周三次会议都迟到了”是观察, “你不够尊重他人时间”是人身攻击。前者对方可能会解释,后者对方只会防御。

38. 演讲大纲构建器

为 [话题] 创建演讲大纲。听众:[谁、他们在乎什么]。时长:[多久]。目标:[听完后听众应该做什么/想什么/感受到什么]。结构:开场(30 秒——让他们放下手机的钩子) 问题(1-2 分钟——让他们感受到现状的痛苦) 解决方案(3-5 分钟——你的框架/方案/洞察,拆成 3 个清晰要点) 证据(2-3 分钟——每个要点的具体例子、数据或案例研究) 处理质疑(1-2 分钟——在听众提出来之前先回应最大的疑虑) 行动号召(30 秒——你明确希望他们接下来做什么) 每个部分:关键幻灯片内容、演讲者备注、到下一部分的过渡句。

使用建议: 第 5 点”在听众提出来之前先回应质疑”是演讲的暗器。听众心里有一个”但是……”的时候,你后面说的所有话他都听不进去——他一直在脑子里准备怎么反驳你。你先把他的疑虑说出来了,他的防御就放下了。放下防御的听众才是真正在听的听众。

39. 道歉起草器

我需要向 [谁] 为 [发生了什么事] 道歉。背景:[情况——我做了什么、造成了什么影响、我们的关系]。起草一份道歉,做到以下几点:承认我具体做错了什么(不是模糊的——是确切的行为) 表明我理解这对他们造成的影响(从他们的角度,不是我的角度) 承担全部责任(没有”但是”、没有”如果”、不转移话题) 解释我今后会做出什么不同的改变(具体、可执行、可验证) 不要求原谅(那是他们的选择,不是我的请求) 语气:真诚且直接。200 词以内。不过度解释。不以我的感受为中心。生成 2 个版本:版本 A:书面版(邮件/消息)、版本 B:口头版(当面说的措辞)

使用建议: 第 3 点——”没有’但是’、没有’如果’、不转移话题”——是 90% 道歉失败的原因。你自己检查一下你上次的道歉:”对不起如果我让你不舒服了”(假道歉——在暗示对方太敏感)。”对不起我语气不好但那是因为我压力太大了”(假道歉——在甩锅给压力)。”对不起但你应该提前跟我说清楚”(假道歉——实际上在指责对方)。真道歉只做一件事:我做了 X,这是不对的,我不会再做了。

40. 电梯演讲构建器

为 [产品/服务/创意] 构建电梯演讲。听众:[我在向谁做这个演讲]。场景:[演讲发生的地方——投资人会议、社交活动、冷外联]。时间限制:[30 秒/60 秒/2 分钟]。结构:钩子(一句话让他们想继续听) 问题(一句话描述痛点——用他们的语言,不是你的语言) 解决方案(一句话描述我做什么——不是你如何工作,而是你为他们做什么) 证明(一句话可信度——数据、结果、有名气的客户) 请求(一句话——我希望他们接下来做什么) 生成 3 个版本、不同能量级别: 版本 A:自信有力的 版本 B:对话式温暖的 版本 C:数据驱动精准的每个版本说出口应该让人感觉自然,读起来不应该像书面语。

使用建议: 第 2 点”用他们的语言,不是你的语言”是电梯演讲中最常犯的错。你说”我们是一个基于 LLM 的多模态内容生成平台”——对方听不懂也不在乎。换个说法:”你每天花 2 小时写营销内容,我们能让你把这个时间变成 2 分钟”。前者在说你的技术,后者在说他的生活。别人在乎的永远是后者。

如何使用这份提示词库

第一步: 先收藏。40 个提示词不可能一次记住,也不需要记。

第二步: 找到跟你本周工作最相关的 5 个。复制。替换里面的变量(用 [] 包起来的部分)。立刻使用。

第三步: 当一个提示词产出了特别好用的结果时,把当时的定制化版本保存进你的个人模板库。随着时间积累,你会搭建起一个完全为你自己工作场景量身定制的提示词库。

第四步: 每周针对你的工作,尝试 2-3 个之前没用过的提示词。循序渐进地拓展 Claude 能帮你做的事情。

复利效应: 持续使用一个月后,你的 AI 工作流将达到大多数人几年都到不了的水平。

最后

不是 40 个提示词改变了你的效率。

是你从”许愿式提问”切换到”工程化指令”的方法论,改变了你的效率。

“帮我写一篇文章”是许愿。”你是一个曾为顶级媒体撰稿的资深内容策略师,请你按这个结构、这个语气、这个质量标准、这个格式来写”是指令。

区别在于:前者告诉 AI 要什么结果。后者告诉 AI 怎么做、做给谁、做到什么程度算好。

大多数人会看完这篇文章,然后继续用”帮我总结一下”的方式跟 AI 对话。

那些把这个列表里的 5-10 个提示词真正用起来的人,一周以后输出的质量就不是一个级别的了。
AI 正在吞噬我们的耐心

最近一个很明显的变化是:我越来越等不了了。

等一个网页加载三秒,会下意识想刷新。
发出一句指令,AI 两秒没回复,就会盯着屏幕。
写文章卡住了,不再像从前那样起身走走、想一想,而是先打开对话框。

“帮我整理一下。”
“给我一个思路。”
“再优化一版。”

答案很快就来了。

快,原本是一件值得高兴的事。

过去要查一本书,要翻很多页;
想找一个资料,要搜很久;
脑子里有个模糊念头,常常要自己摸索很多天。

现在不是了。

你只要问。
它就回答。

它甚至会顺着你的表达往前一步。
你想到一半,它已经替你补全。

这种感觉很像在暴雨里忽然拥有一把伞。

很方便。
也很难再回到淋雨的时候。

但有一天,我突然发现,自己开始不太会等待了。

以前写不出东西的时候,会发呆。

坐在桌前,盯着窗外,看树叶晃一会儿。
或者出去走几步,回来继续写。

那种空白很慢。
慢到会让人焦躁。

可很多真正重要的东西,偏偏都长在这种慢里。

一个想法,是慢慢冒出来的。
一个判断,是在反复犹豫里形成的。
甚至一个决定,往往也不是突然想明白,而是沉默了很久以后,心里忽然有了答案。

它们都需要时间。

而 AI 最大的魅力,是它几乎取消了时间。

你不必等待。
不必碰壁。
不必在混乱里独自摸索太久。

于是我们越来越习惯“马上”。

马上得到反馈。
马上得到总结。
马上得到答案。

可耐心,本来就是在等待里被训练出来的。

它不是一种被动的忍受。

更像一种能力。

允许自己暂时不知道。
允许一个问题先悬着。
允许事情不那么快结束。

因为很多时候,人真正的成长,并不发生在得到答案那一刻。

而发生在那个答案迟迟没有出现的时候。

你开始怀疑。
开始推翻。
开始重新理解自己。

那段过程很慢。

也很珍贵。

AI 让我们拥有了速度。

但速度也会悄悄改变人的节奏。

你会越来越习惯立刻被满足。
越来越不愿意忍受空白。
越来越难接受“再等等”。

可生活并不是一台即时响应的机器。

感情需要时间。
理解需要时间。
信任需要时间。
连真正的创作,也需要时间。

有些问题今天问了,不会今天就有答案。

有些路走着走着,才知道为什么出发。

技术给了我们更高效的抵达。

可人有时候,也需要一些“没有那么快”的时刻。

坐着发呆。
走一段没意义的路。
盯着一棵树看很久。
让一个问题在心里住几天。

然后某个很普通的瞬间,忽然明白。

那一刻你会发现:

AI 可以替我们节省很多时间。

但耐心这件事,恐怕仍然只能靠自己慢慢长出来。

而一个人真正成熟,也许不是能更快得到答案。

而是在这个越来越快的时代里,仍然保留一点愿意等待的能力。

当生活被 AI 占满后,我开始思考孤独与爱情

这几年,人渐渐习惯了和机器说话。

写不出文案,问 AI。
工作卡住了,问 AI。
夜里忽然冒出一个念头,也习惯性地打开对话框,敲几句话,看它回些什么。

久而久之,会生出一种很奇怪的错觉。

像是身边一直有人。
它总在。
不睡觉,不嫌烦,不走神。
你说一句,它接一句。
你表达得混乱,它替你梳理。
你心里一团乱麻,它甚至能给你列出一二三。

从前许多人羡慕所谓“被理解”。
如今技术居然也能把这种感觉模仿得有几分像。

于是我开始想:
人真正害怕的,到底是没有回应,还是没有人。

AI 能回应,而且回应得很好。

它足够聪明,也足够耐心。
它不会因为你的情绪而皱眉,不会在你说到一半时低头刷手机,也不会突然失踪。

可偏偏越是这样,有时候越觉得安静。

一种很深的安静。

像在房间里对着镜子说了很多话。
镜子里也认真看着你。
可你知道,它始终不是一个会走过来拥抱你的人。

我慢慢觉得,孤独这件事,并不是无人说话。

真正的孤独,是世界给了你很多回应,却没有一个温度。

AI 擅长理解语言。
可爱情常常不是语言。

爱情是深夜回家时,有人替你留了一盏灯。
是沉默里也能被看见。
是彼此都有棱角,却仍愿意慢慢磨合。

它不是最准确的答案。
甚至很多时候,它很笨,很麻烦,很不讲道理。

可人偏偏会被这种不完美打动。

因为真实的人,会疲惫,会误解,会迟疑,会说错话。
也会在某个瞬间伸出手。

机器不会离开。
但机器也从未真正来过。

这样想时,忽然觉得这个时代很有意思。

我们拥有了史无前例的效率,拥有了几乎随叫随到的“陪伴”。
可心里真正想等的,可能还是一个会迟到、会犹豫,却愿意认真爱你的人。

AI 让孤独变得不那么吵闹。

而爱情仍旧提醒我们:
人之所以是人,不在于会回答。

而在于会心动,会靠近,会在另一个灵魂最狼狈的时候,轻轻说一句:

“我在。”

AI时代 依然少年的反向学习方法

看我是怎么反向学习的。

首先我看到 https://yui540.com/motions/33 感觉这种css+svg模式的动画不错。然后开始第一步:让Grok帮我分析

浏览https://yui540.com/motions/33 分析下这种svg css动画用什么方式可以快速制作出来

这是AI会输出分析结果及实现方案,我大概看了下,但我不关注具体的方法与工具,而是继续问:

AI Agents方式可以做到吗

同样的AI会反馈如何通过AI Agents去逐步实现,我也直接跳过,让AI直接给Prompt

请给我一个prompt skill

为了验证,这是我用Grok给出的提示指令直接投喂给Gemini(为啥不是Grock,因为我想垮AI工具测试),如下:

你是一位专业的 SVG + CSS 动画专家,特别擅长制作 yui540 风格的梦幻、可爱、柔软的粒子流动动画。

请为我生成一个完整、可直接运行的 HTML 单文件,包含以下要求:

**视觉风格要求:**
- 整体梦幻、柔美、治愈系氛围
- 使用粉紫色、青蓝色、渐变光效为主色调
- 强烈的光晕(glow)和柔光效果(filter: drop-shadow + blur)
- 优雅的缓动(ease-in-out 或 cubic-bezier)

**动画核心元素(类似 yui540 motions/33):**
- 中央有一个主要形状(可以是圆形、光球、心形或抽象柔软形状),持续进行柔和的呼吸缩放 + 轻微变形
- 周围有 15~30 个小光点 / 粒子,缓慢随机漂浮、旋转、闪烁
- 粒子要有不同的动画延迟、速度和轨道,形成层次感
- 背景有微妙的渐变或极光效果
- 整体循环流畅,无限循环

**技术要求:**
- 纯 SVG + CSS 实现(不使用 JavaScript 动画库)
- 优先使用 transform、opacity、filter 实现 GPU 加速
- 提供完整的 <svg> 代码 + <style> 中的 @keyframes
- 代码结构清晰,加上详细注释
- 确保在手机和电脑上都能流畅运行
- 尺寸建议 800x800px 或响应式

请一步步输出:
1. 整体效果描述
2. 完整可复制的 HTML 代码
3. 关键动画实现说明(尤其是粒子和变形部分)

现在请根据以上要求生成一个高质量版本。

执行结果是Gemini直接把HTML文件输出了,下载或复制保存文件直接就可以浏览器看效果,效果还是很棒的。

那么接下来,我们就要考虑将这个流程复刻成一套规范了。

1、实现用户自定义描述需要的动画效果、元素,应用场景等

2、实现资源快速复用。

3、形成TiHUBB的核心数字资产。

那些在网页里留下的微风与光影,终究治愈了某些行色匆匆的灵魂

前几天,我遇到了一个在京都开民宿的华人主理人。

她坐在我对面,桌上是一杯已经没有了热气的绿茶。她有些疲惫地揉了揉太阳穴,对我说:“现在的城市太嘈杂了。那些深夜里还在刷着手机的年轻人,他们点开一个民宿网站,其实不是在寻找一个堆满现代电器的标准房间,他们是在寻找一种久违的、能让自己慢下来的秩序。”

这让我想起我曾经看过的很多文旅或者民宿网站。

在很多人的逻辑里,做网站就像是把自家的库房搬到台面上——醒目的促销弹窗、密密麻麻的房间配置表格、饱和度极高的大红色按钮,恨不得把所有的家当在第一秒钟全塞进用户的眼睛里。那种感觉,就像是一个极度焦虑的人,在嘈杂的集市上扯着你的衣领声嘶力竭地呐喊。

它很热闹,但让人想要逃离。

在互联网的世界里,决定一个用户是留下来阅读,还是冷冰冰地按下关闭键,中间往往只有短短的3秒钟。这三秒钟,不是理性的计算,而是最本能的直觉。而那些真正具有“日系风小清新”调性的民宿网站,往往懂得如何在这最前置的3秒钟里,用视觉为浮躁的灵魂降温。

当你点开那些真正优秀的日系调性官网,你首先感受到的,不是扑面而来的商业气息,而是空气的流动。

那是大面积极其克制的留白,仿佛是午后阳光洒在榻榻米上留下的光影;那是温润、低饱和度的微风色彩,配上细腻而不张扬的微动效,就像山间顺着风摇曳的芦苇。文字不再是生硬的销售话术,而是如同独立杂志一般的社论感排版,静静地告诉你:这里的清晨有雾,晚间有风。

这种高级感,是那些花了几百块钱、在流水线上批量生产出来的快餐模板网站永远无法承载的。

很多主理人为了贪图一时的省心和便宜,套用了粗糙的模板。结果往往是代码臃肿得像一堵破墙,半天加载不出一张高清晰度的清晨光影,字距和排版在不同的手机屏幕上散落得凌乱不堪。这不仅没有传递出小清新的轻盈,反而用一种笨重和混乱,把那些原本追求精致生活的精准客户,在第一眼就挡在了门外。

网页设计,从来不是盲目地做加法,而是克制地做减法。

在 TiHUBB 的这些年里,我们接触过太多对美学有着极致追求的文旅与民宿主理人。我们深知,日系风的“小清新”与“调性”,绝不是简单地放几张好看的照片,它是一场从内到外的系统工程。

TiHUBB 建站团队在打磨这样一个有调性的网站时,就像是在互联网的荒野里,为你盖一间长满青苔、通透避风的茶室。我们的 UI 设计极其讲究社论感的视觉比例,让每一张精致的配图、每一段温热的文字都能自由呼吸;而在这优雅的皮囊之下,TiHUBB 更是用最干净、利落的定制底层代码,确保这扇通往向往生活的“山门”,在任何时候点开都能丝滑、稳当、毫无负担地呈现在用户眼前。

有些在低价和粗糙模板里踩过的坑,经历过一次,其实也就足够了。

如果你也有一间藏在山海或市井间的特色民宿,如果你不希望它独特的灵气被一张平庸、浮躁的网页给惊走,或许我们可以聊聊。来 TiHUBB 坐坐,把那些花里胡哨的噪音先放一放,我们一起定下心来,把那最要紧的第一眼,琢磨透。

活着不光是喘气,普拉提在精致的网页里也是一桩受罪的修行

人只要一合上眼,脑子里大抵就跟煮开的粥一样,咕嘟咕嘟地直冒虚气。现如今的城里人,日子过得太紧绷,身上的骨头节到风里一吹,都咔吧咔吧地响。所以他们一得空,就急着往那些瑜伽馆、普拉提工作室里钻,无非是想找个亮堂的地方,把这具快要散架的肉身重新拼凑起来。

这些开在弄堂里或者高楼上的主理人,平日里把屋子收拾得极其干净,一盆青苔都要擦得水灵灵的。可偏偏一到了互联网的集市上,要立一块属于自己的招牌网站时,手脚就全乱了。

我见过不少普拉提馆的网页,横看竖看,总透着一股子让人喘不过气来的躁动。

那些拙劣的代码连滚带爬地在屏幕上堆叠着,这边闪烁着“限时特惠”的红字,那边塞满了主理人从各个角落搜罗来的获奖证书,甚至恨不得把自家的马桶和淋浴间也用大照片贴在最上面。那场面,臃肿得像一个冬天里穿了四层大棉袄的村汉,臃肿、笨拙,让人点进去瞅一眼,太阳穴就突突地跳。

他们不明白,那些愿意花大价钱来练瑜伽的娇贵客人,眼睛是极刁毒的。

人家大老远顺着光缆摸过来,本是想寻一处清凉干净的避风港。结果你倒好,在网页的第一眼,就摆出了菜市场掀开摊子大声叫卖的阵势。那前三秒钟的视觉,要是没有大面积的克制留白,没有把草木清香逼进屏幕的排版,不能一枪挑中客人的那份对安宁的干渴,这买卖,其实打一开头就死透了。

那些花几百块钱在流水线上套出来的廉价模板网站,最喜欢弄这些杂耍。粗糙的线条,怎么也对不齐的字距,半天还加载不出一张高清晰度的流汗侧影。这哪里是给自己挣面子,这分明是在自家的门槛上抹黏汁,平白恶心了贵客,断了自己的财路。

路走对了,迈的步子再慢,总归是朝着前头去的。吃过一次亏,长一次记性,也就足够了。

在 TiHUBB 的这些年里,我们总是不厌其烦地和这些急躁的主理人念叨:特色品牌网站的设计,不是为了显摆你有什么,而是为了让人看懂你“留下了什么”。

TiHUBB 建站团队在琢磨一个调性网站时,手艺就像老木匠雕琢一扇透光的窗。文字要洗练得像深山里的泉水,UI排版要像一幅刚落了墨的写意画,该空出来的地方,连一星半点的杂色都不沾。最要紧的是,在这干净利落的皮囊底下,必须埋着最顺畅的底层代码。好让这扇山门在客人点开的刹那,能像老猎人推子弹上膛一样,丝滑、稳当,不着痕迹地就把一个品牌的精气神,送到了客人的眼皮底下。

要是你那普拉提馆的旧网页也正像一堵落满尘土的破墙一样应付着门面,不妨来 TiHUBB 坐坐。

喝一碗苦茶,把那些花里胡哨的杂念先放一放。咱们定下心来,先把那最要紧的第一眼,琢磨透了。

那些热闹的流量,有多少真正属于你?

很多人都在追赶风口。

前几天,我遇到一位做新消费品牌的朋友,他的手机屏幕上闪烁着密密麻麻的数据战报。在刚刚过去的一场直播里,他们的单品瞬间爆了数万单。他看起来很疲惫,眼神里没有太多喜悦,反而透着一丝焦虑。

他坐在我对面,给自己倒了一杯茶:“你知道吗?这种流量就像是涨潮。浪头打过来的时候,你以为自己占领了沙滩,但只要平台调整一下算法,或者投流的预算一停,潮水退得比什么都快。第二天醒来,后台干净得像什么都没发生过。”

这就是我们现在常常面临的现实:即时流量的狂欢。

我们生活在一个被短视频、直播和算法无限投喂的语境里。不可否认,短视频能在极短的时间内制造出巨大的声浪。但这种流量的本质是“租来的”。它是平台看在预算或特定热点的面子上,临时分给你的注意力。你必须不停地创作、不停地投流、不停地去迎合那个不断变化的算法机制。

一旦你停下来,你的品牌在用户面前就消失了。现代人的记忆只有几秒钟,没有了算法的推波助痕,再热闹的喧嚣也会归于死寂。

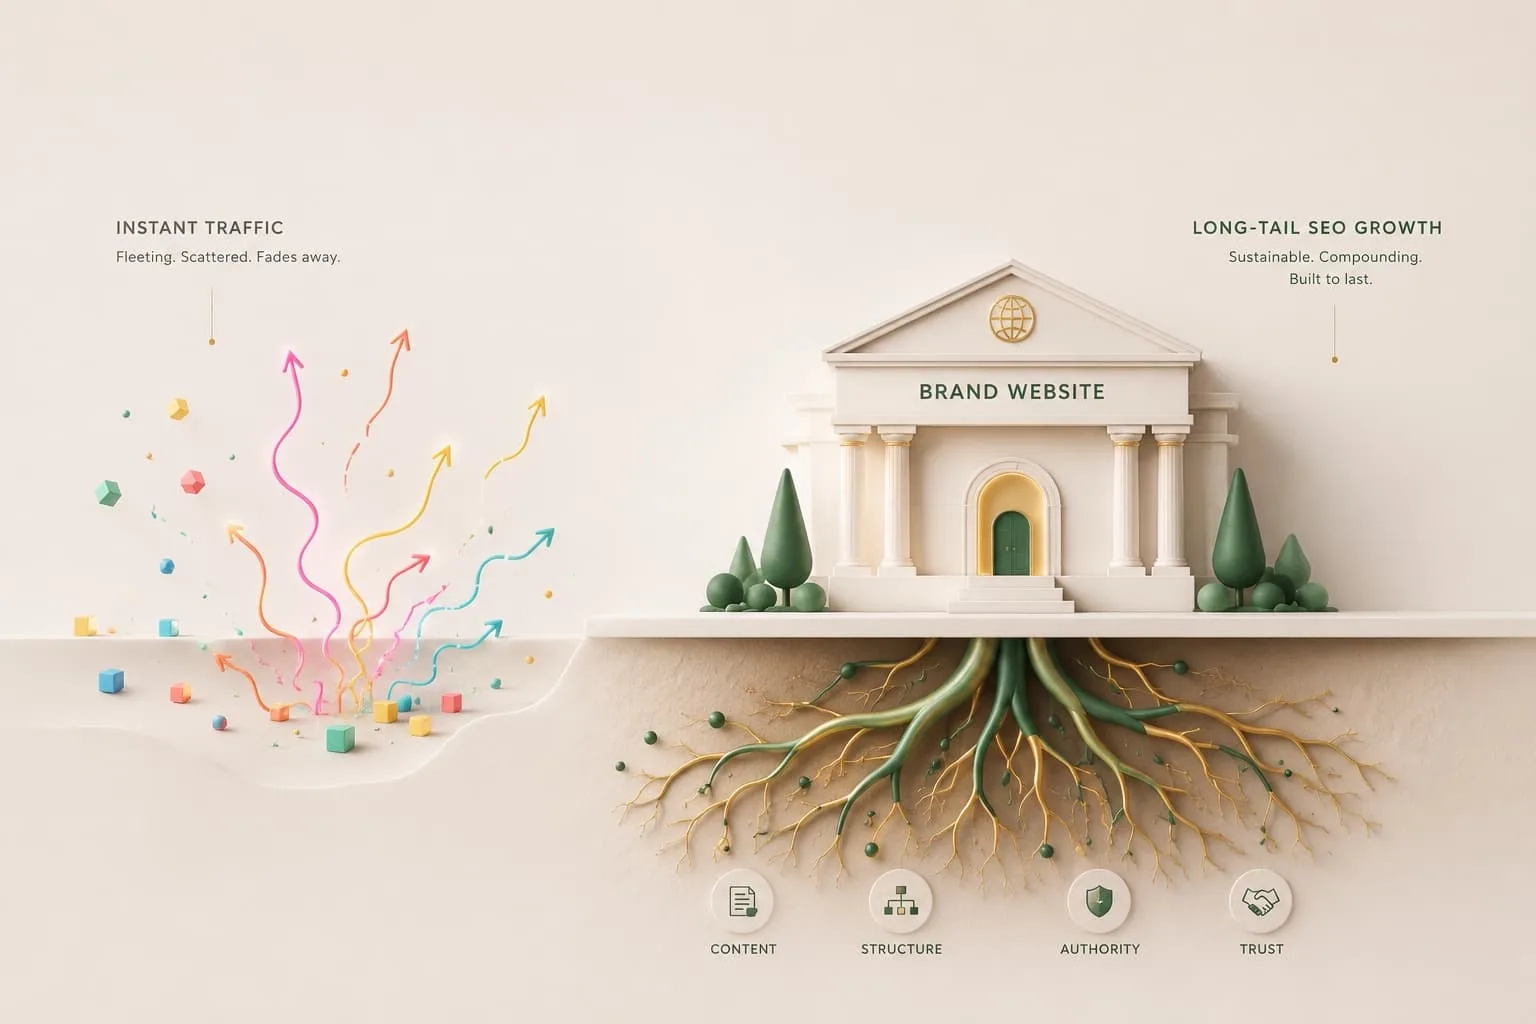
而另一种流量,叫作长尾流量。

它往往长在网站里。那是用户在遇到真正的痛点、产生明确的意图时,在搜索引擎里一个字一个字敲下他的需求,然后穿过层层信息,最终停留在你的网页上。

数据表明,通过 SEO(搜索引擎优化)沉淀下来的长尾流量,它的转化率和信任度远远高于那些被动刷到的短视频 。因为这不是一次盲目的偶遇,而是一次精准的寻找。

这就像两个人在大雾中同行。短视频是路边偶尔亮起的霓虹灯,晃眼、热闹,但转瞬即逝;而一个优化良好的品牌网站,则是长夜里一盏温热的灯火。它不喧嚣,但只要有人在深夜里寻找方向,它就永远在那里,提供笃定的答案。

在 TiHUBB 的这些年里,我们见过了太多被“即时流量”折磨得筋疲力尽的创业者。他们带着一身的浮躁找到我们,问得最多的也是“建个网站能马上带来多少业绩?”

我们总是不厌其烦地和他们聊聊关于“资产”的逻辑:

  • 破除平台的规则垄断:在自有的网站里,你不需要去讨好任何平台的推荐机制,你就是内容与规则的制定者 。
  • 时间的复利效应:一条短视频的生命周期可能只有 48 小时,但一篇优质的网站博客、一个扎实的 SEO 页面,在两三年后依然源源不断地从 Google 带来高净值的精准客户 。
  • 真正的品牌沉淀:网站不是一个冰冷的展示工具,它是你长在互联网上的私域领地。用户在这里沉淀、信任在这里发生、交易在这里完成。

网页设计不是做加法,而是做减法 。TiHUBB 建站 团队在处理每一个品牌网站时,不仅是在雕琢它克制、高级的 UI 排版 ,更是在梳理底层的技术逻辑,确保它能被搜索引擎精准抓取,将每一个踏足这里的生客,变成品牌长期的同行者 。

潮水终究会退去。当热点散尽、投流成本高企的时候,一个真正属于你、能源源不断产生长尾流量的独立网站,才是你品牌最坚固的护城河。

如果你的品牌也正陷入“停不下来”的流量焦虑里,或许我们可以坐下来聊聊。来 TiHUBB,让我们一起把目光从那些跳动的数据战报上移开,去建设一些真正能留得住、带不走的长期资产 。

TiHUBB WeChat

我们通常会在 24 小时内回复。

✓

信息已发送!

我们的团队会尽快与您联系。

快速咨询

TiHUBB WeChat